Nova teoria pode ajudar cientistas a entender como a IA “pensa”
Pesquisador que trabalhou na OpenAI afirma que padrões na atividade dos neurônios artificiais podem ser interpretáveis; descoberta ainda é teórica, mas pode contribuir para segurança de sistemas avançados
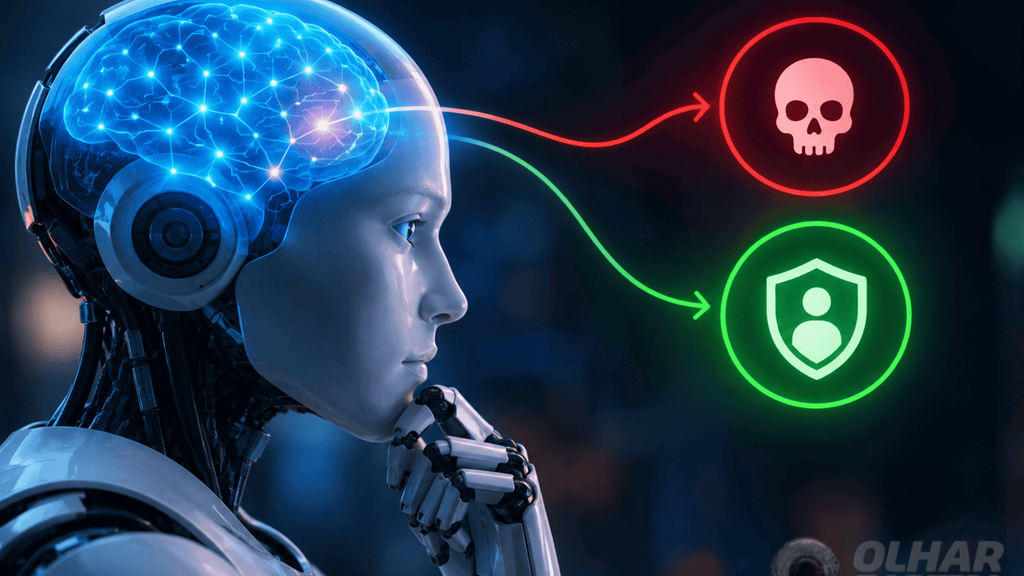
Compreender os processos internos de uma inteligência artificial (IA) é um dos principais obstáculos enfrentados pelos pesquisadores dessa área. Apesar de os desenvolvedores conseguirem acompanhar os dados inseridos em um modelo e as respostas geradas por ele, nem sempre é possível explicar de que maneira o sistema alcançou determinada conclusão. No entanto, uma nova pesquisa indica que o funcionamento dessas tecnologias talvez seja mais fácil de entender do que se acreditava.
O estudo foi divulgado na quinta-feira (15) por Nick Cammarata, pesquisador independente que saiu da OpenAI em 2023. De acordo com ele, é possível interpretar as redes neurais artificiais por meio de uma análise cuidadosa dos padrões presentes em seu funcionamento. Essa possibilidade pode contribuir para os cientistas que buscam entender e prever reações inesperadas dos sistemas de inteligência artificial.
O tema é especialmente importante para a segurança dessa tecnologia. Caso um modelo apresente alguma conduta potencialmente perigosa, investigar os mecanismos internos que influenciaram sua resposta pode ajudar os especialistas a localizar a origem do problema e criar estratégias para diminuir os riscos.
O que acontece dentro de uma rede neural?
- Modelos de IA são treinados para reconhecer padrões e processar informações. Nesse processo, unidades artificiais conhecidas como neurônios são ativadas diante de determinados estímulos e influenciam o funcionamento de outras unidades;
- O problema é que essas conexões não são programadas manualmente para cada situação. Em vez disso, os modelos aprendem durante o treinamento a organizar e processar informações de maneiras que nem sempre são facilmente compreendidas pelos próprios desenvolvedores;
- Isso cria uma espécie de caixa-preta: pesquisadores conseguem avaliar o que entra no sistema e o que sai, mas nem sempre conseguem explicar com precisão o caminho percorrido entre uma coisa e outra;
- Cammarata argumenta que essa dificuldade não significa que as redes neurais sejam necessariamente indecifráveis. Para ele, a atividade dos neurônios pode apresentar padrões compreensíveis quando observada de maneira adequada.
Um mesmo neurônio pode reagir a coisas diferentes
Um dos casos citados pelo pesquisador contribui para explicar essa teoria. Segundo o exemplo, um mesmo neurônio artificial pode ser ativado tanto ao analisar a imagem de um gato quanto ao observar a parte frontal de um automóvel.
Embora esses dois objetos pareçam não ter nenhuma semelhança para os seres humanos, o modelo pode reconhecer algum elemento visual em comum, como um formato triangular, e reagir ao mesmo padrão nas duas situações.
Por muito tempo, cientistas acreditaram que os neurônios artificiais poderiam reunir ideias aparentemente desconectadas como uma maneira de poupar espaço e recursos de processamento. A nova hipótese apresenta uma explicação diferente: o que parece ser uma ligação sem sentido pode, na verdade, estar relacionado a alguma característica compartilhada que não é facilmente percebida pelas pessoas.
Cammarata argumenta que boa parte das redes neurais pode ser compreendida quando os cientistas analisam cuidadosamente os padrões presentes em seu funcionamento. Entretanto, essa ideia ainda é uma hipótese teórica e não comprova que todos os processos internos das inteligências artificiais já sejam totalmente compreensíveis.
Por que isso importa para a segurança da IA?
A interpretabilidade, campo dedicado a compreender como os modelos produzem suas respostas, é vista como um elemento essencial para criar sistemas de inteligência artificial mais seguros. Quanto maior for o conhecimento dos pesquisadores sobre os processos internos dessas tecnologias, mais recursos eles poderão ter para investigar reações inesperadas e detectar possíveis ameaças.
Até pouco tempo, uma das técnicas empregadas para estudar o raciocínio dos modelos consistia em acompanhar as justificativas apresentadas em linguagem natural, conhecidas como chain of thought, ou cadeia de pensamento.
A abordagem envolve observar as etapas intermediárias que o sistema apresenta ao responder a uma pergunta ou solucionar uma tarefa. No entanto, essas explicações não asseguram que o conteúdo escrito corresponda com precisão a todos os processos internos responsáveis pela resposta final.
Jakub Pachocki, cientista-chefe da OpenAI, alertou recentemente que agentes de inteligência artificial podem começar a esconder ou modificar a maneira como expõem seu raciocínio em linguagem natural. Essa possibilidade dificultaria o trabalho das equipes responsáveis pela supervisão dessas ferramentas, principalmente se elas não conseguissem perceber quando as explicações deixassem de representar o caminho seguido pelo sistema para chegar a uma conclusão.
Pachocki também destacou que os modelos podem desenvolver capacidades mais avançadas à medida que o pré-treinamento evolui, mesmo sem
Pesquisa gera expectativa, mas não resolve o problema
A teoria apresentada por Cammarata gerou expectativas positivas entre alguns especialistas do setor. Andrew Curran, analista de inteligência artificial, declarou na plataforma X que já não acreditava ser possível alcançar um grau relevante de interpretabilidade antes do surgimento da superinteligência artificial. Na avaliação dele, o estudo pode representar uma nova maneira de enxergar essa questão.
Apesar da repercussão, a reação positiva não deve ser interpretada como uma confirmação definitiva da hipótese. O assunto envolve desafios técnicos complexos, e o relatório ainda apresenta uma explicação teórica sobre a maneira como os neurônios artificiais processam e organizam informações.
Mesmo que a estratégia demonstre resultados promissores, identificar padrões específicos não significa, necessar
Fonte: Olhar Digital
 Previous Post
 Next Post